Brand Analytics Suchbegriffbericht: Fehlende Amazon Keywords finden

Die „RUF Schlagcreme“ wird für „schlagcreme“ angeklickt. Doch „tortencreme“ fehlt im Listing, obwohl Konkurrenzprodukte dafür Klicks erhalten. Genau solche Lücken lassen sich mit Brand Analytics aufspüren: fehlende Keywords, die Sie nach einer Relevanzprüfung in Ihr Listing aufnehmen können.
An diesem Beispiel gehen wir die Analyse mit dem Brand Analytics Suchbegriff-Bericht durch. Ein Python-Script gleicht die Suchbegriffe mit Ihren Listingdaten ab und ermittelt fehlende Amazon Keywords. Den Abgleich können Sie anschließend für Ihren gesamten Produktkatalog ausführen.
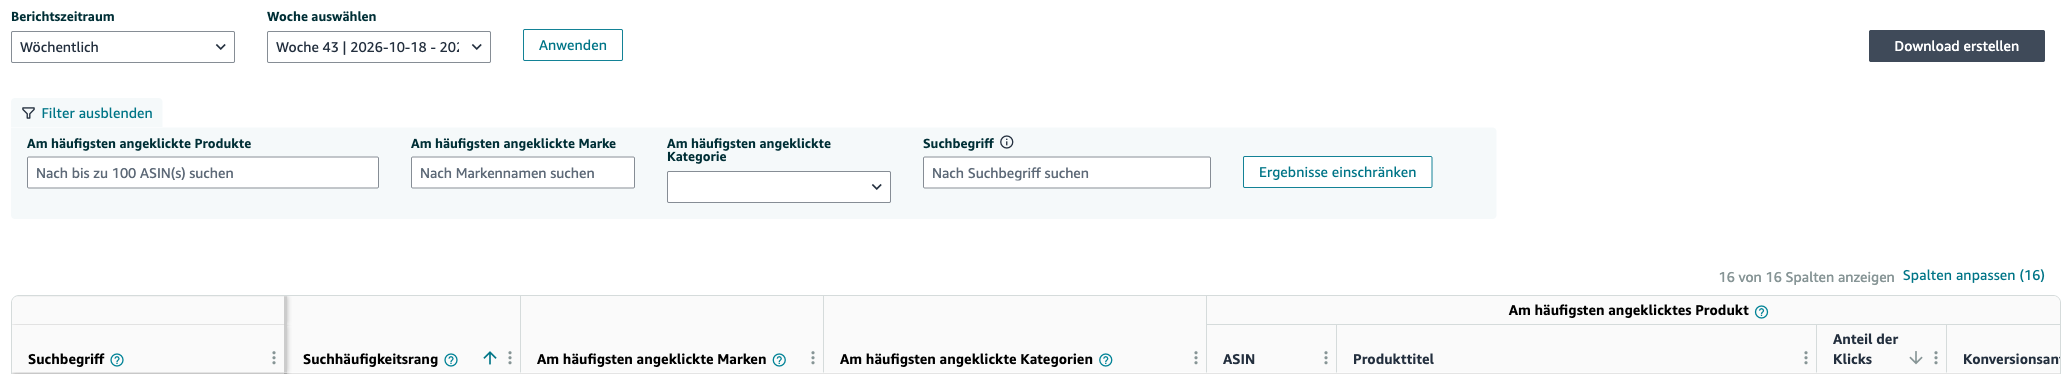
Brand Analytics Suchbegriff-Bericht: Inhalt und Struktur
Den Brand Analytics Suchbegriff-Bericht (heute „Häufigste Suchbegriffe“, englisch „Top Search Terms“) gibt es für Tage, Wochen, Monate und Quartale. Der Wochenbericht enthält für Deutschland rund 500.000 bis 600.000 Suchbegriffe (Stand Oktober 2026). Für jedes Keyword zeigt der Bericht die Top 3 ASINs, die von Kunden nach der Suche am häufigsten angeklickt werden, inklusive deren „Anteil der Klicks“ und „Konversionsanteil“.
Damit sehen Sie, welche Produkte nach einer Suche die Klicks bekommen. Das ist der Ausgangspunkt für die Keyword-Recherche und den Vergleich mit der Konkurrenz. Wie Sie den Bericht nutzen, erklärt unser Artikel zum Brand Analytics Suchbegriffbericht.
Fehlende Keywords mit Brand Analytics identifizieren
Von den Klicks auf Ihr Produkt zu den Lücken im Listing: Der Abgleich läuft in 5 Schritten.
Wir ermitteln:
- Für welche Suchbegriffe Ihr Produkt geklickt wird
- Welche anderen ASINs für die Suchbegriffe aus 1. angeklickt werden
- Für welche Suchbegriffe die ASINs aus 2. angeklickt werden
- Welche Suchbegriffe in 3. enthalten sind, aber in 1. nicht
- Welche Suchbegriffe aus 4. in Ihrem Listing fehlen
Einmal programmiert, wiederholt das Skript diese Schritte für alle Ihre Produkte.
Benötigte Daten für die Keyword-Analyse
Für den Abgleich brauchen Sie zwei Datensätze:
- Einen (aktuellen) Brand Analytics Suchbegriff-Bericht. Dieser steht Sellern mit der Rolle Markenvertreter in der Markenregistrierung sowie Vendoren zur Verfügung und kann in Brand Analytics über „Download erstellen“ heruntergeladen werden
- Eine CSV Datei mit den eigenen Listingdaten.
Die CSV Datei mit den Listingdaten sollte diese Spalten enthalten. Übernehmen Sie die Namen so, wie sie im Code unten stehen:
- Marketplace (z.B. “DE”)
- ASIN (child)
- Product Title
- Bullet Point 1
- Bullet Point 2
- Bullet Point 3
- Bullet Point 4
- Bullet Point 5
Wenn Sie auch die Allgemeinen Schlüsselwörter prüfen möchten (auch “hidden keywords” genannt), ergänzen Sie das Skript um dieses Feld. Dort ist Platz für relevante Suchbegriffe zusätzlich zu Titel und Bullet Points.
Schritt-für-Schritt: Keyword-Ideen mit Python ermitteln
Als Beispiel dient die “RUF Schlagcreme”. Die Daten in den Tabellen unten stammen aus dem Jahr 2021.
Zuerst laden wir den Suchbegriff-Bericht und die Listingdaten. Danach folgen die fünf Abgleiche.
Vorbereitung: Brand Analytics Daten in Python laden
Der folgende Code lädt die Brand Analytics Suchbegriff-Daten. Die Spaltennamen stammen aus einer Datei von 2021. Passen Sie sie an die Kopfzeile Ihrer heruntergeladenen Datei an.
fileNameBA = "./Amazon-Suchbegriffe_DE.csv"
thousandSeparator = "." # DE
columns = ["Suchbegriff","Suchfrequenz-Rang ","#1 der angeklickten ASINs","#2 der angeklickten ASINs","#3 der angeklickten ASINs"] # DE
# columns = ["Search Term","Search Frequency Rank","#1 Clicked ASIN","#2 Clicked ASIN","#3 Clicked ASIN"] # US

# Load data
dfBA = pd.read_csv(fileNameBA, thousands=thousandSeparator, usecols=columns, engine="python", on_bad_lines="error", encoding='utf-8', skiprows=1,  sep=",")

# Rename columns
dfBA.columns = ['searchterm', 'rank', '1', '2', '3']

# Unmelt dfBA from wide to long
dfBA_Long = dfBA.melt(id_vars=["searchterm", "rank"], var_name="position", value_name="ASIN")

# Make position an int
dfBA_Long = dfBA_Long.astype({"position": int})

# Drop N/A
dfBA_Long = dfBA_Long.dropna()

# Reset index and sort
dfBA_Long_WithIndex = dfBA_Long.set_index('searchterm')
dfBA_Long_WithIndex = dfBA_Long_WithIndex.sort_index()
Nach dem Entpivotisieren steht jede ASIN mit Suchbegriff, Rang und Position in einer eigenen Zeile (Auszug):
| searchterm | rank | position | ASIN |
|---|---|---|---|
| auslaufhahn 3/4 zoll | 363709 | 3 | B00SWKL7UW |
| coros apex | 123402 | 2 | B07XKW73D7 |
| beanie mütze | 184043 | 1 | B06XS14S7Q |
| bose qc35 ohrpolster | 96365 | 1 | B00OCL621Y |
Listingdaten laden
Für den Vergleich mit Titel und Bullet Points brauchen wir die Listingdaten. Im Beispiel sind sie bereits im Dataframe df_Products geladen:

Beide Datensätze sind geladen. Jetzt beginnt der 5-Schritte-Abgleich.
Schritt 1: Keywords für das eigene Produkt ermitteln
Zuerst filtern wir den Brand Analytics Suchbegriffbericht nach der ASIN der Schlagcreme:
# Get "owned keywords", i.e. keywords the ASIN in question is clicked on already
ASIN = 'B003SNIRXI'
ownedKeywords = []
foundKeywords = dfBA_Long[dfBA_Long['ASIN'] == ASIN].searchterm.unique()
ownedKeywords.append(foundKeywords)
Für diese Suchbegriffe wird die Schlagcreme angeklickt:
| searchterm | rank | position | ASIN |
|---|---|---|---|
| schlagcreme | 236213 | 1 | B003SNIRXI |
| ruf tortencreme | 370376 | 2 | B003SNIRXI |
| sahnepulver | 175608 | 3 | B003SNIRXI |
| sprühsahne ohne zucker | 336804 | 3 | B003SNIRXI |
Dieselben Begriffe als Array:
['schlagcreme' 'ruf tortencreme' 'sahnepulver' 'sprühsahne ohne zucker']
Schritt 2: Konkurrierende ASINs identifizieren
Welche anderen ASINs tauchen bei „schlagcreme“, „ruf tortencreme“, „sahnepulver“ und „sprühsahne ohne zucker“ auf? Wir sammeln sie und entfernen die eigene ASIN:
# Get other ASINs from competitors for ownedKeywords
otherASINs = []
for searchterm in ownedKeywords[0]:
    # print(searchterm)
    foundASINs = dfBA_Long[dfBA_Long['searchterm'] == searchterm].ASIN.unique().flatten()
    otherASINs.append(foundASINs)

# Flatten array of arrays
flat_list_ASINs = [item for sublist in otherASINs for item in sublist]

# Make array unique
flat_list_ASINs = set(flat_list_ASINs)

# Remove own ASIN
flat_list_ASINs.remove(ASIN)
Übrig bleiben diese Konkurrenz-ASINs:
{'B004WW9QZW',
 'B01N29KQL6',
 'B06XQM4T25',
 'B07KZPP6JK',
 'B07X9GMZHV',
 'B08DDTPPDW'}
Schritt 3: Keywords der Konkurrenz-ASINs analysieren
Für die ASINs aus Schritt 2 lesen wir nun alle Suchbegriffe aus, für die sie angeklickt werden:
# Get keywords the other ASINs are clicked on
keywordsFromOtherASINs = dfBA_Long[dfBA_Long['ASIN'].isin(flat_list_ASINs)].searchterm.unique()
Die Liste enthält bekannte Begriffe wie „schlagcreme“ und weitere wie „vegane sahne“:
['tortencreme' 'sahnepulver' 'torten creme' 'vegane sahne'
 'sprühsahne ohne zucker' 'ruf tortencreme' 'schlagcreme' 'sprühsahne']
Schritt 4: Neue Keyword-Chancen identifizieren
Von der Liste aus Schritt 3 ziehen wir die Keywords unseres Produkts aus Schritt 1 ab.
# Get keywords which other ASINs are clicked on but not the own ASIN yet
A = np.array(ownedKeywords)
B = np.array(keywordsFromOtherASINs)
missingKeywords = np.setdiff1d(B, A)
Diese Suchbegriffe bleiben übrig:
['sprühsahne' 'torten creme' 'tortencreme' 'vegane sahne']
Anschließend zerlegen wir die Suchbegriffe in einzelne Wörter und behalten alle Keywords mit mehr als vier Zeichen:
# Flatten array of arrays and remove duplicates using a set
missingKeywords_flattened = set(' '.join(missingKeywords).split(' '))

# Only get keywords which have a minimum length of 4
missingKeywords_flattened_reduced = [str for str in missingKeywords_flattened if len(str) >= 4]
missingKeywords_flattened_reduced.sort()
Die sortierte Wortliste sieht so aus:
['creme', 'sahne', 'sprühsahne', 'torten', 'tortencreme', 'vegane']
Schritt 5: Fehlende Keywords im eigenen Listing finden
Welche Wörter aus Schritt 4 fehlen im Titel und in den Bullet Points der Schlagcreme?
Dafür wandeln wir alles in Kleinbuchstaben um und verbinden die Bullet-Points zu einer Zeichenkette.
# Get the product title for ASIN in question
productTitle = df_Products[df_Products['ASIN (child)'] == ASIN]['Product Title'].values[0].lower()

# Get a string of all 5 bullet points
allBullets = []
currentProduct = df_Products[df_Products["ASIN (child)"] == ASIN]
for i in range (1,6):
    allBullets.append(currentProduct['Bullet Point ' + str(i)].values[0])

allBulletsCombined = ' '.join(allBullets)
Nun prüfen wir für jedes Wort, ob es im Titel oder in den Bullet Points vorkommt:
# Check if a term from missingKeywords_flattened_reduced is not in product title or bullet
termsNotFoundInListing = []
for term in missingKeywords_flattened_reduced:
    if (term.lower() not in productTitle) and (term.lower() not in allBulletsCombined.lower()):
        termsNotFoundInListing.append(term)

print("Missing keywords: " + str(termsNotFoundInListing))
Im Listing fehlen:
Missing keywords: ['sprühsahne', 'tortencreme', 'vegane']
Passende Begriffe können Sie in Titel, Bullet Points oder den Allgemeinen Schlüsselwörtern ergänzen. So verbessern Sie Ihre Chancen, für diese Suchbegriffe gefunden zu werden.
Wichtig: vegane gehört nur ins Listing, wenn die Schlagcreme tatsächlich vegan ist. Prüfen Sie jeden Vorschlag auf seine Relevanz für Ihr Produkt. Irreführende Keywords können negative Bewertungen und schlechtere Rankings nach sich ziehen.
Fazit: Automatisierte Keyword-Analyse mit Brand Analytics
Bei der Schlagcreme bleiben „sprühsahne“, „tortencreme“ und „vegane“ zur Prüfung übrig. Für ein einzelnes Produkt lässt sich der Abgleich von Hand erledigen. Bei Hunderten von ASINs übernimmt Python die Vergleiche mit den Daten aus Brand Analytics und prüft den Katalog in wenigen Sekunden auf Keyword-Lücken.
Die Vorteile auf einen Blick:
- Automatisierte Analyse des gesamten Produktkatalogs
- Identifikation von Keywords, die Konkurrenten bereits nutzen
- Export der Ergebnisse in übersichtliche Excel-Dateien
- Regelmäßige Wiederholung für kontinuierliche Optimierung möglich
Ergänzen Sie die Keyword-Analyse durch weitere Amazon SEO-Maßnahmen und regelmäßiges Controlling über Brand Analytics.
Ressourcen für Ihre Keyword-Optimierung:
- Das vollständige Python-Notebook: GitHub Repository
- Weitere Analysen mit AMALYTIX: Kostenlos testen
- Vertiefende Artikel: Amazon SEO Guide
Newsletter abonnieren
Erhalten Sie die neuesten Amazon-Tipps und Updates direkt in Ihr Postfach.
Mit der Anmeldung stimmen Sie unserer Datenschutzerklärung .
